運営:Next Life運営局(株式会社Rush up) 会社概要|編集方針
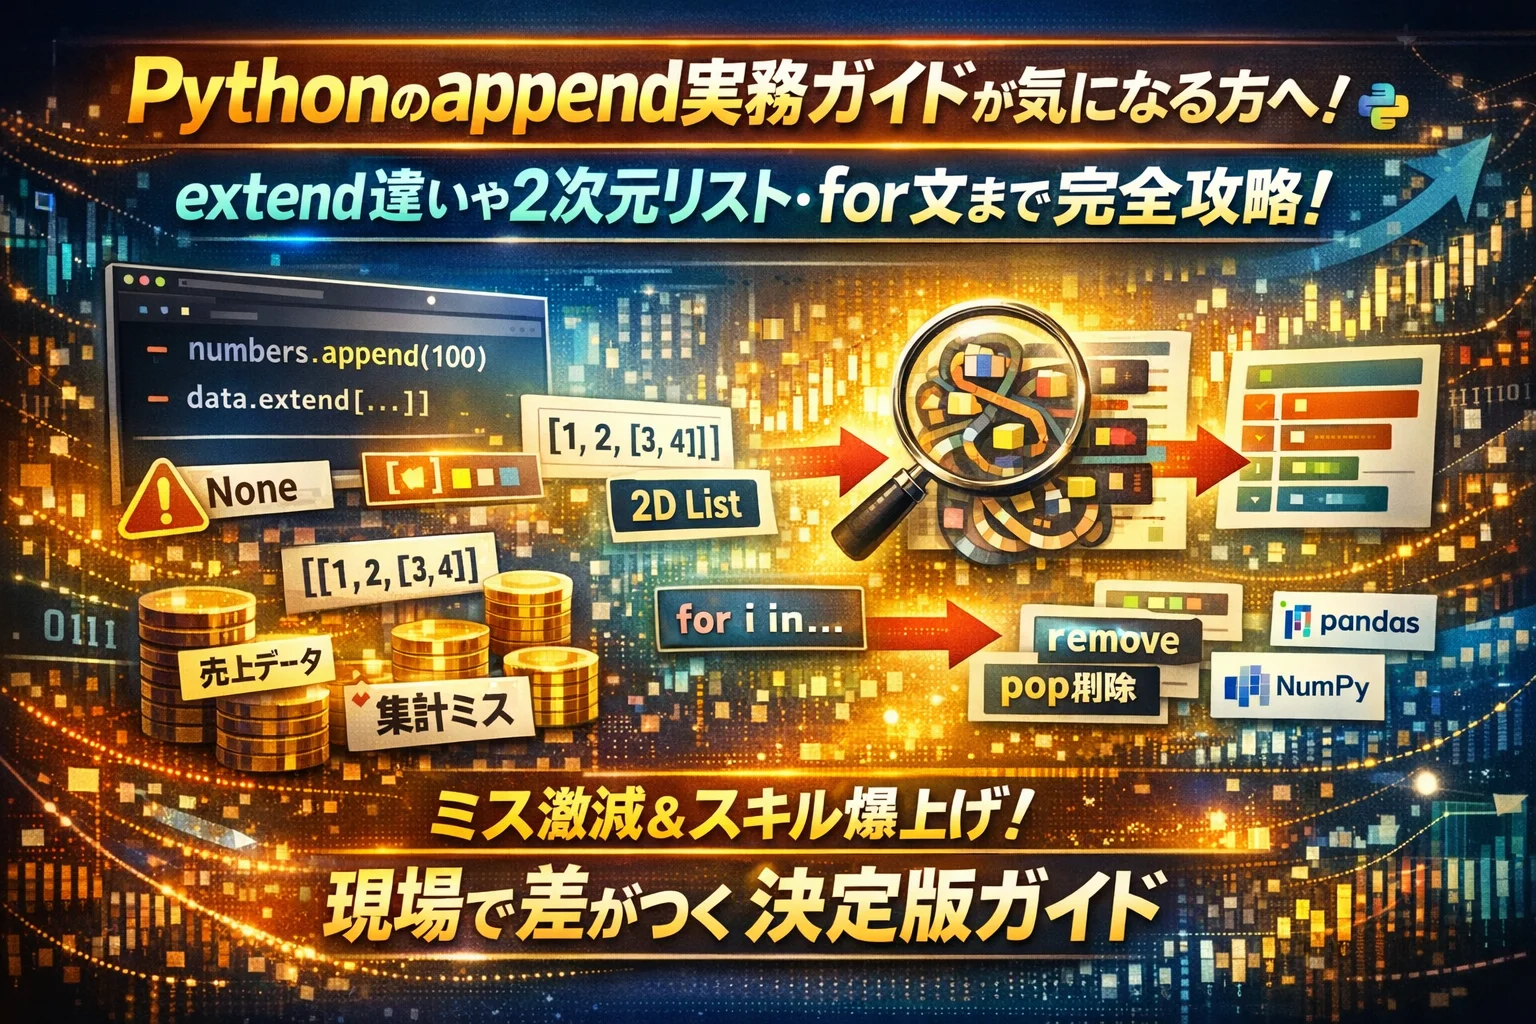
Pythonのappendで書いたスクリプトが「動くのに結果がズレる」「リストが二重三重になって配列が崩れる」「appendが遅い気がする」と感じているなら、すでに見えない損失が出ています。多くの解説は、appendの使い方や文法だけを切り出して終わるため、extendとの違いや2次元リストでの参照共有バグ、for文との組み合わせ、削除との併用まで一気通貫で整理できません。
Pythonのappendは『箱ごと追加』するメソッドで戻り値がNone、extendやinsertとの使い分け、2次元リストでの参照共有バグ、データ構造設計を理解することが、配列ズレや集計ミスを防ぐ鍵になります。
- appendは『箱ごと追加』するメソッドで戻り値がNoneため、代入して使うとバグが発生しやすく、正しい書き方はlst.append(item)で元のリストが変更されます。
- extendは『中身だけ連結』する方法で要素の数が増えるため、行の追加と列の追加では選ぶメソッドが異なり、設計段階で『1要素を何とみなすか』を明確にすることが重要です。
- 2次元リストでの参照共有バグは、同じリストオブジェクトを複数回参照すると全行が同じ値になるため、『行ごとに新しい箱を作ってからappendする』習慣でミスを防げます。
本記事は、Pythonのlistに要素を追加するすべての場面を「業務データの扱い」という軸で再構成しています。appendとextendとinsertの違い、リストへの複数追加や2次元配列への行追加、リスト結合のパフォーマンス、removeやpopとの組み合わせ、さらには「とりあえず全部append」が半年後にどんな負債になるかまで、現場で実際に起きている失敗パターンから逆算して解説します。
売上データや広告レポートを扱うWeb担当者やエンジニアが、Python appendとは何かをコードと設計の両面から理解し、二度と配列ズレや集計ミスで時間と機会を失わないための実務ガイドとして、必要な答えをこの1本に集約しました。
- appendとは何者か?Pythonのappendがリストへ「箱ごと追加」される仕組みとは
- Pythonでappendを使うときに絶対ハマる3つの落とし穴と回避のコツ
- appendとextendとinsertの使い分け図鑑!リスト追加と結合の違いを完全体感
- for文とappendでリストを育てる方法|ループと内包表記や2次元リスト実践レシピ
- 「複数追加」「文字列」「2次元」――現場でよく出るappend活用レシピ集
- appendは本当に遅い?リスト結合のパフォーマンスを体感し「気にするべき境界線」を知る
- 削除と組み合わせて使うappend例|remove・pop・delとのリアルな活用法
- そのappendで将来もラクできる?現場で差がつく「データ構造の選び方」とは
- 4,000社以上のWeb支援で見えた「小さなデータ構造ミス」がビジネスを狂わせる本当の理由
- この記事を書いた理由
appendとは何者か?Pythonのappendがリストへ「箱ごと追加」される仕組みとは
「動くのに結果がヘンだ」と感じるとき、多くの場合このメソッドのイメージがずれています。appendは、リストという棚に「箱ごと」荷物を増設していく道具です。1件ずつログを積む、売上データを時系列で蓄積する、スクレイピング結果を貯めるなど、実務の多くはこの「棚に箱を足す」作業の連続です。
裏側で起きているのは、リストの末尾に「新しい要素への参照」を1つ足しているだけです。ここを押さえておくと、2次元リストが崩れたり、文字列がバラけたり、戻り値Noneでバグったりする理由が一気につながります。
appendの基本シンタックスと「戻り値None」問題を一気に理解しよう
まず押さえたいのは次の2点です。
-
appendはリスト自身をその場で変更するメソッド
-
呼び出し結果は必ずNoneを返す
よくあるバグはこの形です。
-
new_list = old_list.append(x)→ new_listにはNoneが入り、old_listだけが更新されます
実務でKPI一覧や広告レポートを扱うスクリプトをレビューすると、この書き方のせいで「集計結果が全部None」「一部のデータが欠落」という事故にかなりの頻度で遭遇します。代入せずに呼ぶだけ、ここが最初のチェックポイントになります。
リストへ数値や文字列やリストや辞書をappendしたときの違いを全部まとめて比較
appendは「箱ごと追加」なので、中身の型によってリストの形が大きく変わります。よく使うパターンを一覧にすると次の通りです。
| 追加するもの | 例 | リストの形の変化 | よく使う場面 |
|---|---|---|---|
| 数値 | 1 | [1, 2] → [1, 2, 3] |
ID、数量、スコア |
| 文字列 | “2024-01” | ["2023-12"] → ["2023-12", "2024-01"] |
日付ラベル、カテゴリ名 |
| リスト | [1, 2] | → [0, [1, 2]] |
2次元リストの1行追加 |
| 辞書 | {“date”:…, “cv”:…} | […] → […, {"date":…, "cv":…}] |
行データ、ログ1件分 |
ポイントはリストを追加したときだけ「入れ子」になることです。
アクセス方法も変わります。
-
数値を積む:
scores[-1] -
辞書を積む:
rows[-1]["date"] -
リストを積む:
matrix[-1]
マーケティングデータで「日付順がずれている」「列の意味がわからない」といった混乱が起きるのは、多くがこの構造の取り違えです。テスト時点で最後の1件をprintして形を目視確認する習慣をつけておくと、大半の事故は防げます。
「リスト(配列)」と呼ばれるPythonのlist、その正体と役割とは
Pythonのlistは、他言語の「配列」と似ていますが、現場視点では次の3つが本質です。
-
順番が大事なデータの入れ物
広告出稿日のタイムライン、セッションの発生順、ABテストの結果など、「並び順そのものが意味を持つ」データを扱うのに向いています。
-
何でも入るが、何でも入れると読めなくなる
数値も文字も辞書も混在できますが、可視化やSQL連携を考えると、「1リスト=1軸」「1要素=1行(または1レコード)」というルールを最初に決めておくと後工程が圧倒的に楽になります。
-
appendは設計の甘さを隠してしまう
とりあえずappendで全部突っ込むと、その場では気持ちよく動きます。ただ半年後、「どのインデックスに何が入っているか」をチームメンバーが誰も説明できない状態になりがちです。
プログラミング学習の教材では文法だけが説明されがちですが、データ活用の現場では「このリストは何を時系列で並べた棚なのか」を一文で言語化できるかどうかが、ミスを減らす最大のポイントになります。私の視点で言いますと、appendを覚えること自体より、この一文を決める癖のほうが、長期的な成果へのインパクトはずっと大きいと感じています。
Pythonでappendを使うときに絶対ハマる3つの落とし穴と回避のコツ
「動くのに結果が気持ち悪い」。リスト操作で時間を溶かす原因のほとんどは、appendの挙動を“なんとなく”で使っているケースです。ここでは現場で実際に多発している3つの落とし穴に絞って、サクッと抜け出せるコツをまとめます。
ネスト地獄にならないために知る!リストへリストをappendしたときの二重・三重配列あるある
appendは「箱ごと追加」するメソッドです。
数値や文字だけでなく、リストを渡したときも中身ではなくリストそのものが1要素として入ります。
よくあるパターンは次のような感覚違いです。
-
期待している形
["apple", "banana", "orange"]を1本の配列にしたい -
実際に起きている形
[["apple", "banana", "orange"]]のように、外側に1段リストが増える
一覧データをpandasやBIツールに渡したとき、「行が1つしかない」状態になるのはこのネスト地獄が原因になりがちです。
中身だけを連結したいときは、extendか+演算子で「要素レベルでくっつける」発想に切り替えると安定します。
2次元リストで全行が同じ値になる「参照共有バグ」がなぜ起こるのか
2次元リストの初期化で、次のような書き方をしているケースは要注意です。
-
rows = [ * 3] * 5のように書く -
同じ空リストをループで
appendし回している
このとき内側のリストは同じオブジェクトを5回参照しているだけになります。
1行目だけを書き換えたつもりでも、他の行もすべて同じリストを指しているため、全行が同時に変わってしまいます。
安全な考え方は「行ごとに新しい箱を作ってから、それを外側のリストにappendする」ことです。
-
行の初期化はループの内側で毎回新しく行う
-
2次元リストを扱うときは、
id()関数やis演算子で、行同士が同じオブジェクトになっていないか一度確認する
私の視点で言いますと、マーケティング指標を日別×媒体別の2次元リストにためているスクリプトでこのバグが出ると、「全日同じ数値」という最悪のレポートが静かに量産されるので本当に危険です。
appendの結果がNone?やってはいけない代入例と正しい書き方
appendはリストをその場で変更するメソッドで、戻り値は常にNoneです。
ここを勘違いすると、次のような「どこかでNoneが紛れ込んだ」系バグにつながります。
-
やってはいけない書き方
new_list = old_list.append("apple")
→new_listの中身はNoneになる -
正しい書き方の考え方
- 変更系メソッドは「戻り値は捨てて、変わった元のリストを使う」
- 新しいリストを作りたいときは、
old_list + ["apple"]のように式で返す方法を採用する
挙動を整理するために、代表的なパターンを比較しておきます。
| やりたいこと | 書き方 | 戻り値 | 元のリスト |
|---|---|---|---|
| 既存リストをその場で1要素追加したい | lst.append(item) |
None |
変更される |
| 新しいリストとして要素を足したい | new = lst + [item] |
新しいリスト | 変わらない |
| まとめて中身だけ連結したい | lst.extend(other_list) |
None |
変更される |
| まとめて連結して新しい配列にしたい | new = lst + other_list |
新しいリスト | 変わらない |
「代入して使うのは式」「命令として使うのはメソッド」と頭の中で役割分担しておくと、None混入トラブルはほぼ防げます。
今書いているスクリプトの中で、右辺にappendが出てきていないか、一度grepして洗い出しておくと安心です。
appendとextendとinsertの使い分け図鑑!リスト追加と結合の違いを完全体感
「とりあえず全部append」で書き始めると、気付いた頃には配列がぐちゃぐちゃになりやすいです。ここで一度、追加メソッドをプロレベルで整理しておきます。
「箱ごと追加」と「中身だけ連結」―appendとextendの本質的な違いをコード比較で理解
リスト操作でまず押さえたいのは、何を1要素とみなすかです。そこを取り違えると、マーケ指標の行数が合わないといった事故につながります。
代表メソッドの違いを一覧にするとこうなります。
| メソッド | 動きのイメージ | 典型コード | 結果の長さの増え方 |
|---|---|---|---|
| append | 箱ごと1個追加 | lst.append([1, 2]) | +1要素 |
| extend | 中身をバラして連結 | lst.extend([1, 2]) | +n要素 |
| insert | 指定位置へ箱ごと差し込み | lst.insert(0, x) | +1要素 |
| + 演算子 | 新しいリストを作成して結合 | lst + [1, 2] | 左右の合計 |
マーケデータの例でいうと、
-
日次売上を1日ごとに「レコード1件」として扱いたい → そのレコードをappend
-
既存の売上リストに、別システムから来た「複数日の売上リスト」を結合したい → extendか+演算子
という判断になります。
よくある落とし穴
-
文字列にextendを使うと、
"2024"が["2","0","2","4"]にバラバラになる -
リストにリストをappendすると、
[[売上1日分], [売上1日分]]という2次元リストになる
どちらが正しいかは、「1要素を何とみなしたいか」です。ここをコメントで明示しておくと、半年後に自分が救われます。
配列や2次元リストをまとめて追加したいときの最適なテクニック
配列や2次元リストを扱う場面では、「行を増やしたいのか、列をくっつけたいのか」でメソッドが変わります。
| やりたい事 | 例 | おすすめ書き方 | ポイント |
|---|---|---|---|
| 行を1つ追加 | 1日分のKPI行を追加 | rows.append(new_row) |
new_rowはリストかタプル1件 |
| 行をまとめて追加 | 1週間分を一気に追加 | rows.extend(week_rows) |
week_rowsは行のリスト |
| 列を横に連結 | 既存KPIに新指標列追加 | list内包やzipを使用 | appendではなく行ごと再構成 |
2次元リストで行を追加したい時にextendを使うと、行が壊れます。
NG: table.extend(new_row)(new_rowが1行ぶんなら列がバラける)
OK: table.append(new_row)(1行まるごと追加)
私の視点で言いますと、KPI集計で一番多いバグは「本当は行を追加したいのに、列として扱ってしまう」ケースです。forループでログを回しながら、1レコードを1行のリストか辞書としてappendしていく形にそろえると、pandasへの移行もスムーズになります。
リストの先頭へ要素を追加したいならinsertとdequeどちらがベスト?
レポート生成で「新しいデータを先頭に積んでいきたい」場面もあります。このとき候補になるのがinsertとcollections.dequeです。
| 手段 | 特徴 | 向いているケース |
|---|---|---|
| list.insert(0, x) | 手軽だが要素数が増えると遅くなる | 件数が少ない一時スクリプト |
| list = [x] + list | 新しいリストを生成 | 元のリストを保持したい時 |
| deque.appendleft(x) | 先頭追加が高速 | ログやキューのような継続運用 |
アクセスログや計測結果を「常に新しい順で持ちたい」なら、最初からdequeで設計した方が安全です。先頭へのinsertを乱発すると、要素が1件増えるたびにインデックスをずらすコストがかかり、数万件を超えたあたりから体感でモッサリしてきます。
一方、日次バッチで100件程度を扱うだけなら、読みやすさを優先してinsertを使っても問題は出にくいです。データ量とライフサイクルを見てメソッドを選ぶ、これが現場で差がつくポイントになります。
for文とappendでリストを育てる方法|ループと内包表記や2次元リスト実践レシピ
for文とappendを味方につけられるかどうかで、データ前処理のスクリプトは「育てやすい花壇」にも「雑草だらけの畑」にもなります。ここでは現場で本当に多いバグパターンを踏まえて、最短ルートで安全な書き方にたどり着く道筋を整理します。
for文でリストに値を格納したい!基本パターンと初心者あるあるバグ
最初に押さえたいのは「リストをどこで初期化するか」です。典型的な形は次のイメージになります。
-
空のリストを用意する
-
forループの中で条件に合うデータだけappendする
-
ループ終了後にリストを使う
ここで起きやすいミスは次の3つです。
-
リストの初期化をfor文の中に書く
ループごとにリストがリセットされ、最後の1件しか残らないパターンです。
-
インデントがずれて一部の要素しか入らない
ifの中にappendを書いたつもりが、実は外に出ているなど、Python特有のインデント地獄です。
-
for文の外で結果を参照しているはずが、途中経過をprintし続けている
デバッグprintの位置が悪く、「増えていない」と錯覚しやすいケースです。
マーケデータの集計では「一部のCVだけ漏れていた」という事故につながるので、ループ開始前にリストを1度だけ作れているかを必ずチェックすると安心です。
二次元リストをfor文とappendで作るときの「行の初期化」を失敗しない鉄則
2次元リストになると、バグの種類が一気に増えます。特に多いのは次の2パターンです。
-
全ての行が同じ内容になってしまう
-
一部の行を書き換えたつもりが、別の行も一緒に変わる
原因のほとんどは「同じリストオブジェクトを何度も使い回している」ことです。for文で2次元リストを組むときの鉄則はシンプルです。
-
1行分のリストは、行を追加するたびに新しく作る
-
ループの外で
[[]] * nのような一括初期化を安易に使わない
イメージとしては「同じ箱を行数分コピーする」のではなく、「行ごとに新品の箱を組み立てる」感覚です。私の視点で言いますと、売上データの行追加ロジックをここで間違えると、KPIの配列ズレに半年以上気づけなかった、という相談が非常に多いです。
2次元リストを作るときによく使う書き方の特徴をまとめると次の通りです。
| 書き方のイメージ | ありがちなバグ | 向いている場面 |
|---|---|---|
ループ内で毎回row = []してappend |
書き忘れると全行同じ | 行ごとに加工内容が違う集計 |
[初期値] * nで横方向を作る |
同じオブジェクト参照 | 単純なフラグ配列など小規模 |
| ネストした内包表記 | 可読性が急落しやすい | 固定サイズの表を一括生成 |
特に業務シナリオでは「後から列を増やす」「特定行だけ上書きする」が頻発するため、短さよりも行ごとに独立したリストを確実に作れているかを優先した方が安全です。
リスト内包表記でappendを使わずスマートに書くメリットと落とし穴
for文とappendに慣れてきたら、リスト内包表記を使うとコードは一気に読みやすくなります。
-
条件フィルタと変換が1行にまとまる
-
ループ変数が外に漏れない
-
appendを書き忘れる事故を防ぎやすい
内包表記が強いのは、「1対1で変換する処理」「シンプルな条件での絞り込み」です。一方で、次のようなときは落とし穴になります。
-
2次元リストで行と列の両方をいじる
-
副作用を伴う処理(ファイル保存やAPI呼び出し)を混ぜ込む
-
条件分岐が2段階以上ある
このような場合、内包表記に無理して詰め込むと、後から読む人が「何をしているか分からない1行芸」に苦しみます。データ前処理では、次のような使い分けを意識するとバランスが取りやすくなります。
| 手法 | 向いている処理 | 避けたい処理 |
|---|---|---|
| for文 + append | ログ蓄積、2次元リスト構築、複雑な条件分岐 | 単純な変換だけのワンライナー |
| リスト内包表記 | 数値変換、単純なフィルタ、ID一覧の抽出 | 外部サービス呼び出しや例外処理込み |
| 内蔵関数(map, filter) | 性能をシビアに測る軽量処理 | 可読性が最優先のチーム開発 |
appendと内包表記のどちらを選ぶかは、「将来の自分やチームメンバーがデバッグしやすいか」を軸に決めるのが、現場では最終的に一番コスパが高くなります。
「複数追加」「文字列」「2次元」――現場でよく出るappend活用レシピ集
Pythonでリストへ複数要素を追加する3つの書き方とメリット徹底比較
レポート集計やログ処理をしていると、「1件ずつ追加」から「まとまった塊を一気に追加」に切り替えたくなる瞬間が必ずきます。代表的な3パターンを整理しておきます。
| 方法 | 書き方の例 | 特徴 | 向いているケース |
|---|---|---|---|
| appendをループ | for x in items: lst.append(x) | シンプルで読めるが遅くなりやすい | 件数が少ない・まずは動かしたい時 |
| extendで一括 | lst.extend(items) | 中身だけまとめて連結、最も素直 | リストやタプルをそのままつなぎたい時 |
| 足し算演算子 | lst = lst + items | 新しいリストを作るのでメモリ多め | 元を残したい・イミュータブル風に扱いたい時 |
実務でパフォーマンスを意識するなら、「シーケンスをそのまま足す時はextend」を基本ルールにすると迷いません。私の視点で言いますと、マーケのレポート自動化スクリプトで「とりあえずループ+append」を積み重ねて後から遅さに悲鳴を上げるパターンを何度も見ています。
一方、「1件のオブジェクトを箱ごと追加したい」場合は append が正解です。たとえば計測結果1レコードを辞書で持ち、その辞書を毎回 append するイメージです。ここをextendにしてしまうと、辞書のキーだけが1文字ずつバラけるというカオスが起きます。
文字列をappendとextendどちらで操作する?一文字ずつバラける事故を防ぐコツ
文字列は「シーケンス」扱いなので、extendすると1文字ずつ分解されることが落とし穴です。広告キャンペーン名をリストに追加したつもりが、["C","a","m","p"...]のようなfruits崩壊状態になっている例は珍しくありません。
安全に扱うための指針を整理します。
-
文字列を1件の要素として扱いたい
→
names.append(name_str) -
文字列のリストをまとめて連結したい
→
names.extend(name_list) -
区切り文字で結合して1本の文字列にしたい
→
" ".join(name_list)でリストから文字列へ変換
特に「appendで1件ずつ蓄積 → 最後にjoinで1本のレポート行にする」流れは、ログ出力やCSV生成でよく使うパターンです。逆に、文字列のままextendは原則NGと覚えておくと、一文字ずつバラける事故をかなり防げます。
2次元配列や2次元リストに行・列を追加する安全なやり方
2次元リストは、売上明細やアクセスログのような「行×列」のデータを扱うときの定番ですが、appendの使い方を誤ると一気に訳が分からなくなります。ポイントは「行単位で追加する」「同じリストを使い回さない」の2点です。
2次元リストの行を追加するときの安全パターン
-
1行をリストやタプルで用意し、それを丸ごとappend
- 例:
rows.append([date, campaign, cost])
- 例:
-
ループのたびに「新しい行リスト」を作る
- 同じ行オブジェクトを使い回さない
列を増やしたい場合は、各行に対して個別にappendするのが基本です。
-
既存の2次元リスト
rowsがある -
新しい指標
ctr_listを、行数と同じ長さで用意 -
for i, row in enumerate(rows): row.append(ctr_list[i])のように、行ごとに末尾へ追加
ここでやりがちなのが、「新しい列だけを別リストに貯めておき、後からzipで結合する」つもりが、長さ不一致でズレたまま運用してしまうパターンです。売上とクリック数の配列ズレは、KPI判断を平気で数%単位で狂わせます。
業界人の目線で言うと、2次元リストを扱う時点で「本来はpandasのDataFrameにすべき規模かどうか」を常に意識しておくのが安全策です。とはいえ、小さなスクリプトでlistを使う場面も多いので、行追加はappendで1レコードずつ、列追加は全行に同じ順番でappend、という“素朴だけれど壊れにくい書き方”を標準にしておくと、後からのメンテナンスが圧倒的にラクになります。
appendは本当に遅い?リスト結合のパフォーマンスを体感し「気にするべき境界線」を知る
マーケティング用のログや売上データを毎日スクリプトでためていると、「このappend、地味に遅くないか…?」というモヤモヤが出てきます。ここを感覚ではなくデータ構造レベルで線引きしておくと、「どこから設計を変えるべきか」の判断が一気にラクになります。
append・extend・足し算演算子でリスト結合――どのくらい速さが違う?
まずは3パターンの性格を整理します。
| 手段 | 挙動 | 計算量のイメージ | 得意なケース |
|---|---|---|---|
| append | 要素を1つ末尾に追加 | 1回ごとにほぼ一定時間 | 1行ずつログを積む |
| extend | シーケンスの中身をまとめて追加 | 追加する要素数に比例 | 1日分を一括連結 |
+(足し算) |
新しいリストを作って両方コピー | 両リストの長さに比例 | 小さいリスト同士の結合 |
ポイントは「新しいリストを作るかどうか」です。appendとextendは元のリストをそのまま育てますが、足し算演算子は毎回コピーを作るため、ループの中で多用すると一気に重くなります。
私の視点で言いますと、小さなレポートスクリプトで「なんとなく遅い」と感じるケースの大半は、この足し算演算子をループ内で回しているパターンが原因でした。
Pythonでappendを乱用すると本当に遅い?大量データ時の「モッサリ感」正体を暴く
appendは基本的に1回あたりほぼ一定時間で動きます。内部で必要に応じてまとめてメモリを確保しているため、「毎回メモリ確保で激遅」にはなりません。
それでもモッサリしてくる場面には、だいたい次のような要因があります。
-
何百万行レベルを1件ずつファイルから読み込み、毎回appendしている
-
毎ループで
ifや文字列整形を重ねており、ボトルネックがappend以外にある -
巨大なリストに対して、途中で削除やinsertも多用している
特に3つ目は危険で、リストの先頭へのinsertや途中のdelは、後ろの要素を全部ずらすコストがかかります。追加・削除を混ぜた「ぐちゃぐちゃな更新」を繰り返すと、体感性能は一気に落ちます。
実務では、「1件ずつappendする」こと自体よりも、
-
まとめて読み込めるのに小さく分割しすぎている
-
途中削除とinsertを混ぜている
-
不要な足し算演算子でコピーを量産している
といった設計のほうが本質的な遅さの原因になりやすいです。
listから配列(NumPyやpandas)へ切り替え判断のベストタイミング
リストで押し切るか、NumPy配列やpandasに乗り換えるかは、どこで集計・計算をするかで決めるのが現場では現実的です。
| 状況 | 向いている選択 | 判断の目安 |
|---|---|---|
| ログを一時的にためるだけ | list+append | 追記が中心で計算は軽い |
| 合計・平均・グループ集計を頻繁に実施 | pandas DataFrame | 列単位の集計が多い |
| 数値配列に対して大量の数値演算 | NumPy配列 | ベクトル演算がメイン |
ビジネス現場でありがちなのは、「とりあえず全部リストにappendして、その後for文で合計やグルーピングを回し続ける」パターンです。これをpandasの列操作に切り替えるだけで、計算時間もコード量も桁違いに下がるケースが多く見られます。
切り替えの目安をまとめると、次のようになります。
-
追加よりも「集計・分析」にかける時間のほうが支配的になってきた
-
レポート生成に数十秒〜数分かかり、担当者が待たされている
-
リスト処理のfor文の中で、ifや算術演算が複雑化して読めなくなっている
このラインを超えたら、「リストでappendし続ける設計」を見直し、NumPyやpandasに役割を渡すタイミングです。単なる高速化だけでなく、バグの温床になりやすい長大なfor文が消えるという意味で、データ構造の切り替えはパフォーマンスと品質の両方に効いてきます。
削除と組み合わせて使うappend例|remove・pop・delとのリアルな活用法
ログや売上データをリストに追加していく処理は、appendだけでは完結しません。現場では「間違って入った要素をどう消すか」とセットで設計しておかないと、半年後にレポートの数字が静かに狂い始めます。
最後の要素/指定要素/全ての条件に合う要素削除――3つのやり方と違い
削除系メソッドは、どの軸で消すかを意識して使い分けると事故が減ります。
| 手段 | 削除対象 | 戻り値 | 向いているケース |
|---|---|---|---|
| remove(x) | 値xと一致する最初の要素 | なし | 特定のコード・IDを1件だけ消したい |
| pop(i) | インデックスiの要素(省略時は末尾) | 削除した要素 | スタック・履歴の戻し処理 |
| del list[i] | インデックス・スライス指定の要素 | なし | 範囲削除・大量削除をまとめて行う |
例えば広告ID一覧から、配信停止した1件だけを消すならremove、集計の最後に加えた「確認用データ」を取り除くならpop末尾、テストデータ100件を一気に落とすならdelスライスが読みやすくなります。
appendとpopで作るシンプルなスタックとキューの構築術
appendとpopを組み合わせると、履歴管理や待ち行列をコード数行で表現できます。
-
スタック(後入れ先出し:Undo履歴など)
- 追加: list.append(item)
- 取り出し: list.pop()(末尾)
- 「最後にやった操作から戻す」動きと一致します。
-
キュー(先入れ先出し:処理待ちジョブなど)
- 追加: list.append(item)
- 取り出し: list.pop(0)(先頭)
- ただしpop(0)はリスト全体をシフトするため、件数が増えると顕著に遅くなります。
本格的なキューにしたいなら、標準ライブラリのdequeを使うと、appendとpopleftでほぼ同じ書き味のまま高速化できます。行列の長さが数百件を超え始めたら、リスト運用を続けるかdequeに切り替えるか、一度立ち止まって確認する価値があります。
リストの削除回数が増えたときにパフォーマンスと可読性を両立させるテク
データ前処理の現場で多いのが、「条件に合わないものを1件ずつremoveするループ」です。これは時間もバグも増えやすい最悪パターンになりがちです。
-
条件削除が多いときの安全策
-
元のリストを壊さず、新しいリストを内包表記で作る
-
「残したい条件」を書く(filterの発想)
-
削除を繰り返さず、一度のパスで済ませる
例として、売上が0の行をすべて除外したい場合、removeで回すより、
- 「売上が0でない行だけを集めた新リスト」を内包表記で作る
と決めた方が、バグもパフォーマンス劣化も抑えられます。
私の視点で言いますと、appendでひたすら追加したリストを、後からremoveで細かく削る設計は、コードレビューの段階で必ず止めるようにしています。どのタイミングで「入れるか」「捨てるか」をあらかじめ決めておくことが、レポートの信頼性とスクリプト保守性を両方守る一番の近道だからです。
そのappendで将来もラクできる?現場で差がつく「データ構造の選び方」とは
「とりあえず全部append」で作ったスクリプトが半年後に負債化する理由
業務で集計スクリプトを触ると、「とりあえずリストにappendしまくった痕跡」が必ず出てきます。動いてはいるのに、仕様変更のたびに誰も触りたがらないコードになっていないでしょうか。
ありがちな書き方は、売上やログをそのままリストへ順番だけで詰め込むパターンです。
-
インデックス0は日付
-
インデックス1はキャンペーン名
-
インデックス2は売上
といった「人間の暗記力」に依存した設計だと、半年後に列追加をした瞬間に全てのインデックスがずれ、バグを埋め込んだ状態で運用されがちです。
典型的な失敗の構造を整理すると次のようになります。
| パターン | その場では楽 | 半年後のツケ |
|---|---|---|
| 単純リストへappendで列を増やす | 1行ですぐ書ける | どの位置に何が入っているか誰も分からない |
| 2次元リストに生配列を積み上げる | CSV気分で扱える | 列追加で全行の意味がズレる |
| 型を混在させる(数値と文字列を同じリスト) | 変換を後回しにできる | 集計時にキャスト地獄になる |
私の視点で言いますと、この「インデックス暗記頼み」のスクリプトが、マーケ指標や広告KPIの解釈ミスを静かに生み出しているケースを何度も見てきました。
dictionaryや集合や2次元リストをどう組み合わせれば解析や可視化がラクになるか
負債化を防ぐ鍵は、「あとから読み返したときに、データ構造だけで意味が分かる状態」を作ることです。そのために、listだけで完結させず、dictionaryやset、2次元リストを役割ごとに使い分けます。
| データ構造 | 得意なこと | 典型的な使い方 |
|---|---|---|
| list | 順番が重要なデータ | 日別の売上推移、処理キュー |
| dictionary | ラベル付きの値保持 | キャンペーンIDと指標一式 |
| set | 重複排除と集合演算 | ユニークユーザー数、配信先の差分 |
| 2次元リスト | 表形式の一時保持 | CSV読み込み直後のバッファ |
例えば、日別の売上レポートなら、「1行を丸ごとリストでappend」ではなく、「1日の情報をdictionaryで1件」として扱うと、列追加に強くなります。
-
2次元リストは「一時的な入出力の箱」
-
集計や可視化は「dictionaryやlistの組み合わせ」で表現
という役割分担を決めておくと、後からpandasや可視化ツールに載せ替えるときもスムーズです。
業務フローやレポート設計から逆算する「どでappendすべきか」判断基準
appendを使う場所は、「業務フローのどの地点で、どの粒度のレコードを生やすか」で決めると迷いません。ポイントは次の3つです。
-
入力の粒度を決める
アクセスログ1行なのか、セッション単位なのか、キャンペーン単位なのか。appendする1要素が、ビジネス的に何を表すのかを先に決めます。
-
レポートの軸を先に描く
日別なのか、チャネル別なのか、担当者別なのか。最終的な表の行と列を紙に書き出し、その1行分をdictionaryやlistで表現し、それをappendする設計にします。
-
どこで集計を確定させるか決める
「生ログを全部appendしてから集計」だと、永遠に増え続ける巨大リストを抱えることになります。日次や週次のタイミングで、集計結果だけを新しいリストやdictionaryにappendし直し、元の生データはストレージへ退避する運用が安全です。
まとめると、appendは「なんとなく配列へ足していく道具」ではなく、「ビジネス上の1レコードを、どの構造でどのタイミングで確定させるか」を反映するスイッチです。この視点を持てるかどうかで、半年後にスクリプトを笑いながら改善できるか、エラーの山に怯えながら触るかが、大きく変わってきます。
4,000社以上のWeb支援で見えた「小さなデータ構造ミス」がビジネスを狂わせる本当の理由
売上データや広告レポートでの「配列ズレ」が意思決定をどう左右するか
たった1行のappendミスが、半年分の意思決定をゆがめることがあります。
よくあるのが「指標と日付の配列ズレ」です。日付リストと売上リストを別々にappendしているうちに、ある日だけ片方だけ追加し忘れる。その瞬間から「日付Aの売上」が「日付Bの売上」として扱われ、グラフもレポートも静かにウソをつき始めます。
ズレが怖いのは、エラーにならず「それっぽい数字」が出続けることです。例えば広告費とコンバージョン数を別リストで管理していると、CPCやROASの計算がすべて別物になります。判断の土台が崩れているのに、誰も気づかないまま予算配分が変えられていきます。
配列ズレを防ぐ現場のコツは「1レコードを1つのオブジェクトにまとめてappendする」ことです。日付・媒体・費用・成果をバラバラに追加するのではなく、辞書やタプルで1セットにしてリストへ積み上げるだけで、構造レベルの事故は激減します。
Pythonでappend一つでも「運用ルール」がなければ発生する現場トラブル
実務でよく見かけるトラブルを整理すると、どれも「ルール不在」が原因です。
| よくあるトラブル | 直接の原因 | 本質的な原因 |
|---|---|---|
| 2次元リストの全行が同じ値になる | 同じリストオブジェクトを使い回してappend | 参照とコピーの違いが曖昧 |
| レポート列が途中から1列ずれる | 列ごとに別リストへappendしている | スキーマ定義がない |
| appendの戻り値を変数に入れてバグる | メソッド結果がNoneになる仕様の誤解 | コーディング規約不在 |
| 文字列をextendして一文字ずつ分解される | データ型ごとの振る舞いを把握していない | テストケース不足 |
どれもコード単体で見ると「よくあるミス」で済みますが、マーケ指標や売上データに乗った瞬間、意思決定ミスに変わります。対策としては、技術論の前に次のような運用ルールを決めておくのが有効です。
-
1行分のデータは必ず辞書かタプルにまとめてからappendする
-
2次元リストを初期化するときは内包表記かコピーを明示して書く
-
appendの戻り値は絶対に変数へ代入しないというチーム共通ルールを作る
-
レポート用リストは「スキーマ表」を1枚決めてから実装する
私の視点で言いますと、「どのメソッドを使うか」より「どのミスを絶対に許さないか」を先に合意しておくチームほど、データトラブルが少ない印象があります。
伊藤和則が大事にする「ツールより先にルール」――学びを実務に活かすポイント
appendやextendの文法をどれだけ理解しても、現場での事故はゼロにはなりません。差がつくのは、学んだことをどれだけ「ルール」と「チェックポイント」に落とし込めるかです。
学びを実務へつなげるときのポイントを整理します。
-
データ構造を紙に描く習慣
どのタイミングでどんなリストへ何を追加しているのか、箱と矢印レベルで1度は図解してみると、ズレやすい箇所がはっきりします。
-
テスト用ミニデータで挙動を固定する
3件分だけのサンプルデータでappend処理を走らせ、想定通りの2次元リストや辞書リストになるかを毎回確認します。ここで仕様を固めてから本番データに向き合うと安全です。
-
コードレビューで「構造だけ」を見る時間を作る
処理速度やアルゴリズムより前に、「1レコードはどの単位か」「どこでリストを分けているか」といった構造面だけをチェックするレビューを一度通すだけで、多くの事故の芽は摘めます。
appendは単なるメソッドではなく、「データをどの粒度で蓄積するか」を決めるスイッチです。ここで丁寧に設計しておくほど、半年後の分析やダッシュボード改善がラクになり、ビジネス判断の精度も静かに底上げされていきます。
この記事を書いた理由
著者 – 伊藤 和則(nextlife事業部 責任者)
Pythonのappendをここまで掘り下げたのは、Web集客やSNS運用の現場で「コードは動くのに数字がおかしい」ケースを何度も見てきたからです。売上データや広告レポートの整形をPythonに任せた途端、配列ズレで月次のCV数が合わない、2次元リストの参照共有ミスで全行同じ数値になっていた、といった相談が続きました。
私自身も、自分のPCでレポート自動生成スクリプトを組んだ際、appendとextendを混同して1件ごとの行が二重三重になり、朝から晩まで原因追及に追われた経験があります。こうしたエラーは、一見ただのコードミスですが、経営判断や広告配分を誤らせる「ビジネスリスク」に直結します。
4,000社以上の支援を通じて痛感しているのは、難しいアルゴリズムよりも、listやappendの設計を丁寧にそろえる方が、現場の損失を確実に減らせるということです。本記事では、文法の紹介で終わらせず、「どのようにデータを持たせれば、半年後も安心して運用できるか」という観点で、私が日々の検証とトラブル対応から積み上げてきた考え方をまとめました。Pythonに不安を抱えたままレポート作成を続けている方が、同じ遠回りをしなくて済むようにするための一冊です。
Q. appendとextendの違いは何ですか?
Q. appendで『None』が出てくるのはなぜですか?
Q. 2次元リストで全行が同じ値になるのはなぜですか?
Q. 行をまとめて2次元リストに追加する方法は?
🔗 あわせて読みたい関連記事
 VSCodeでPythonが実行できない原因と解決方法を診断VSCodeでPythonが動かない原因と解決策を網羅。インタプリタ設定、仮想環境の確認、OS別セットアップガイドで、ト…
 Python環境構築で迷わないWindows11とMacVSCodeの完全ガイドPython環境構築で悩まないために、Windows11とMacでの具体的な手順を解説。実行エンジン・作業机・仮想環境の…
 PythonでCSV読み書き・集計を完全マスター!pandasと自動化ガイドPythonでCSVを安全に読み書きするコツを解説。csvモジュール、pandas、トラブルシューティングから業務自動化…
 ExcelでPythonを使い分ける完全ガイド|自動化・VBA・ツール比較ExcelとPythonの連携方法を解説。Python in Excel・openpyxl・xlwings・VBAの使い…
 PythonをWindowsで始める環境構築ガイド|pip・VSCode対応PythonをWindowsに導入する全手順。公式インストーラー・Store版・Anacondaの選び方、PATH設定、…
 Pythonグラフ自動化入門|Excel超えるCSV・ライブラリ比較Excelでは限界な日次更新やデータ量の多いグラフを、Pythonで自動化する実務ノウハウをまとめました。基本フローから…
🧰 お困りごとの解決に
 TikTokコインをコンビニで安くチャージする方法TikTokコインをコンビニでチャージする全ルートを解説。ギフトカード・ブラウザ払い・各店別手順から、最安ルートの選び方…
 TikTok LiteのPayPay連携エラーの直し方TikTok Liteでポイント交換できないエラーの原因と解決策を解説。Wi-Fi切り替えや時間帯の工夫など、PayPa…
 TikTok Liteのアカウント削除とポイントの注意点TikTok Liteのアカウント削除時にポイントが即座に消滅する仕組み、本家アプリとの連動リスク、削除手順、トラブル時…
 Amazonの追跡ID「99」「DA」の意味と配送状況が更新されない時の対処AmazonのトラッキングIDはDA形式ならAmazon配送、数字形式なら各配送業者で、形式ごとに追跡先が異なります。配…
この記事に関連する解説
最近更新した記事
 Netflix広告つきプランで見れない作品の確認手順と鍵マークの原因💡 結論(要点まとめ)Netflixの広告つきプランで見られない作品に付く「鍵マーク(ロックアイコン)」の原因を解説。ラ…
 LINEメッセージが送れない原因と直し方|マーク別の確認手順💡 結論(要点まとめ)LINEでメッセージが送れない時の対処法を症状別に整理。矢印や赤い「!」、警告文、未読の違いを確認…
 Spotifyのオフライン再生のやり方と通信設定の注意点💡 結論(要点まとめ)Spotifyで音楽をオフライン再生する手順を解説。Premiumでのアルバムやプレイリストの保存…
 Amazonプライムビデオのチャンネル請求確認|契約状況と明細の照合💡 結論(要点まとめ)Amazonプライムビデオのチャンネル請求を確認する手順を整理。契約中のチャンネル一覧や更新日の確…
 LINE連動アプリの解除手順と注意点|データ削除との違いを整理💡 結論(要点まとめ)LINEの連動アプリを解除する最新手順を案内。設定画面からの解除操作はもちろん、「連動解除」と「相…